DevOps e Automação
Avaliação de LLMs no CI: como criar testes de qualidade para prompts e respostas
Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.

Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.
Explore guardrails para agentes de IA em servidores, comparando allowlist, sandbox e broker de aprovação para garantir segurança e controle.
Um roteiro técnico para estruturar RAG no Kubernetes com Qdrant, separando ingestão assíncrona e consulta síncrona. O plano inclui decisões de armazenamento, chunking, filtros, exemplos de configuração e cuidados operacionais.
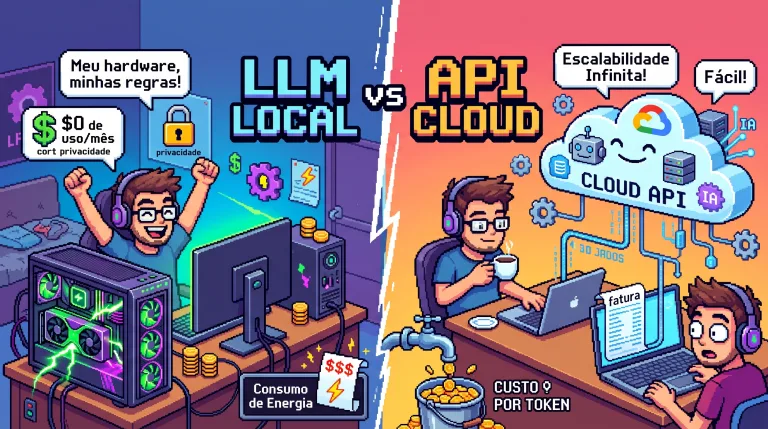
GPU própria e API cloud atendem a necessidades diferentes. Veja como comparar o custo total, a privacidade e o trabalho operacional antes de escolher onde executar um LLM.
Em workloads de inferência, CPU e memória nem sempre mostram quando a capacidade está saturada. Veja como combinar métricas do vLLM e KEDA para escalar pods com base em fila e latência, considerando também o tempo de carregamento do modelo.
Servir LLMs no Kubernetes com vLLM parece simples até o primeiro pico de tráfego. O que separa uma prova de conceito de um serviço confiável é medir TTFT, controlar GPU e aceitar as limitações reais da fila.
Harness aparece em DevOps como uma camada prática para acelerar entrega, testes e governança sem transformar o pipeline em um labirinto. Neste artigo, você vê onde ele entra, onde não entra e como usar a ferramenta com foco real em operação.
Compare BGP, PTT e IPTables em Linux para alta disponibilidade com FRR, keepalived, conntrack e automação em Ansible e GitLab CI.
Comparação técnica entre ext4, XFS e Btrfs no Linux para servidores, NVMe, bancos, containers e automação DevOps, com comandos, exemplos e critérios práticos de escolha.