RAG no Kubernetes com Qdrant: da ingestão de PDFs ao endpoint de perguntas exige separar duas cargas com comportamentos diferentes. PDFs precisam ser processados sem bloquear a API, enquanto os vetores precisam sobreviver à substituição de Pods e a reinicializações do cluster.
O caminho passa por armazenamento de arquivos, parsing, fragmentação, indexação e consulta ao modelo de linguagem. Os exemplos de configuração são pontos de partida: nomes de StorageClass, limites de recursos, credenciais e versões precisam ser adaptados e testados no seu cluster.
A decisão arquitetural que organiza o restante é simples. Workers e API são stateless; o Qdrant é stateful, e essa diferença determina como escalar, persistir, recuperar e pagar pela infraestrutura.
RAG no Kubernetes com Qdrant: arquitetura e limites
Separar componentes stateful e stateless
Imagine uma equipe que publica um conjunto novo de manuais em PDF enquanto usuários continuam perguntando sobre a versão anterior. Se a conversão dos arquivos acontecer dentro do processo da API, um documento grande pode consumir CPU e memória justamente onde a latência de consulta precisa permanecer previsível. Colocar a ingestão em Jobs ou workers independentes mantém esse trabalho fora do caminho síncrono da pergunta.
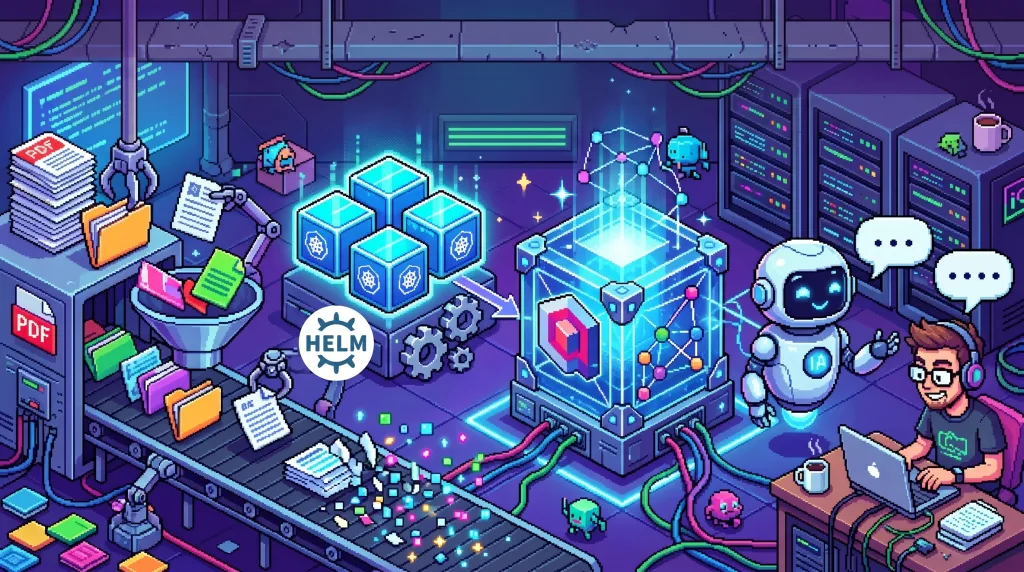
O fluxo fica assim: PDFs brutos seguem para um Object Storage; Jobs ou workers fazem parsing e chunking; o serviço de embeddings converte fragmentos em vetores; e o Qdrant armazena vetores e payloads. Na consulta, a API recebe a pergunta, busca trechos relevantes e encaminha contexto ao gateway de LLM. Cada componente pode então ser operado segundo sua carga, sem transformar a API em um processo monolítico que também varre arquivos.
FastAPI ou Go podem atender a API e orquestrar os passos. Esses serviços stateless rodam como Deployments e podem ganhar réplicas com HPA, usando CPU ou métricas de requisições quando disponíveis. O Qdrant, por sua vez, é stateful: a implantação via Helm Chart oficial e StatefulSet associa Pods a armazenamento persistente, em vez de depender do disco efêmero do container.
Escolher armazenamento e dimensionar o índice
Para o volume do Qdrant, escolha uma StorageClass que corresponda aos requisitos de latência e durabilidade. SSDs de alta performance, como io2 na AWS ou regional-pd no GKE, são opções citadas para esse tipo de carga; a escolha final depende do provedor, da distribuição de leitura e escrita e do custo aceitável. Um PVC sem classe apropriada pode criar um gargalo difícil de perceber até a indexação crescer.
O índice HNSW reside em memória, então RAM faz parte do dimensionamento do banco, não apenas do limite do container. Como referência orientativa, modelos de 768 dimensões podem exigir cerca de 1,5 KB de RAM por vetor; acima de 50 milhões de vetores, a quantização escalar int8 pode reduzir o consumo de memória em até quatro vezes. Esses números não substituem um teste com seus dados, parâmetros de índice, payloads e perfil de consulta.
Meça o conjunto real antes de reservar nós. Vetores, estruturas do índice, metadados e cache competem por recursos, e uma coleção com payloads extensos não se comporta como uma coleção mínima de demonstração. Faça um teste de carga com consultas representativas, acompanhe memória e latência, e registre o tamanho da coleção antes de definir requests, limites e capacidade de armazenamento.
Ingestão de PDFs: armazenamento, parsing e chunking
Processar documentos fora do caminho de consulta
O PDF bruto deve entrar primeiro em um Object Storage, como AWS S3, Cloudflare R2 ou MinIO no cluster. A aplicação registra o identificador do arquivo e dispara um Job ou entrega uma mensagem para um worker; a API de perguntas não precisa aguardar a extração de texto. Esse desacoplamento também permite pausar a ingestão sem interromper consultas a documentos já indexados.
Um worker pode baixar o objeto, validar o tipo de arquivo e executar parsing com ferramentas como Docling ou Unstructured. Ambas atendem a cenários em que o documento contém tabelas, layouts e texto que uma extração simples pode embaralhar. O teste relevante não é apenas verificar que o parser terminou: compare a saída estruturada com páginas do PDF, especialmente quando uma tabela associa valores a cabeçalhos em outra linha.
Trate a ingestão como uma etapa assíncrona com estados observáveis. Um registro associado ao documento pode indicar recebido, em processamento, indexado ou com falha, acompanhado do identificador da execução. Se uma página estiver corrompida, a equipe precisa distinguir uma falha parcial de uma coleção pronta para responder; publicar um documento incompleto como se estivesse íntegro cria respostas com lacunas silenciosas.
Preservar contexto e metadados
Chunking controla quanto conteúdo vai para cada vetor e quanto texto pode ser recuperado para geração. No Parent-Child Chunking, fragmentos menores, como child chunks de 512 tokens, geram os vetores de busca; ao encontrar um resultado, o sistema recupera o parent chunk maior, como um bloco de 2048 tokens. São parâmetros ilustrativos, não valores universais: valide-os com seus PDFs, modelo de embedding e limite de contexto do LLM.
Fragmentos curtos podem localizar um trecho com precisão, mas perder a explicação necessária para interpretá-lo. Um parent maior pode recuperar o parágrafo e sua ressalva, embora também aumente o contexto enviado ao modelo. Para uma tabela de manutenção, por exemplo, armazene no payload a página de origem e vincule o child ao parent, para que o resultado possa retornar o contexto adequado e uma referência verificável.
Inclua no payload campos como document_id, page e tenant_id. Esses dados permitem filtrar a busca por locatário e localizar a fonte da resposta, mas precisam ser tratados como parte do controle de acesso, não como decoração. Defina também uma estratégia de deduplicação: uma nova ingestão do mesmo documento deve substituir ou versionar seus pontos de forma previsível, e uma mudança de parser ou embedding precisa deixar claro quais vetores pertencem a cada versão.
Antes de marcar um documento como disponível, valide a quantidade e a integridade dos pontos escritos. Um fluxo comum cria uma versão de ingestão, escreve os novos fragmentos, verifica o resultado e só então atualiza o estado publicado. Se o processo falhar no meio, o worker pode retomar ou descartar a versão incompleta sem misturá-la aos dados já consultáveis.
Configurar workers e persistência no Kubernetes
Exemplo de configuração declarativa
O diagrama abaixo separa o arquivo armazenado do processamento que o transforma em pontos no Qdrant. Em uma implementação real, um evento do Object Storage ou uma fila pode iniciar o Job; o exemplo não pressupõe um mecanismo específico de mensagens.
Este manifesto é ilustrativo. O worker lê o nome do bucket e a coleção de um ConfigMap, enquanto credenciais ficam em um Secret gerenciado conforme as práticas do cluster; não coloque chaves de Object Storage ou LLM em texto aberto no repositório. O comando depende da imagem e do código da aplicação.
apiVersion: v1
kind: ConfigMap
metadata:
  name: rag-ingest-config
data:
  OBJECT_STORAGE_BUCKET: "documentos"
  QDRANT_URL: "http://qdrant:6333"
  QDRANT_COLLECTION: "manuals"
  EMBEDDING_MODEL: "bge-small"
---
apiVersion: batch/v1
kind: Job
metadata:
  name: rag-ingest-example
spec:
  backoffLimit: 2
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: worker
          image: registry.example/rag-worker:stable
          command: ["python", "-m", "app.ingest"]
          envFrom:
            - configMapRef:
                name: rag-ingest-config
            - secretRef:
                name: rag-ingest-secrets
          resources:
            requests:
              cpu: "500m"
              memory: "1Gi"
            limits:
              cpu: "2"
              memory: "4Gi"
Controles para reprocessamento seguro
O Secret referenciado acima precisa ser criado pelo mecanismo de gestão de segredos adotado pela equipe. A imagem e os limites são exemplos, assim como os valores de CPU e memória: um parser que mantém páginas renderizadas na memória pode exigir limites diferentes de um worker que apenas lê texto. Não execute vários Jobs sem avaliar quanto cada um pode consumir dos nós compartilhados com a API.
Para o Qdrant, mantenha dados em PVC e use um StorageClass existente no cluster. O trecho a seguir demonstra a associação entre StatefulSet e volume; imagem, configuração completa e política de disponibilidade devem seguir o Helm Chart oficial e a topologia efetivamente adotada.
apiVersion: v1
kind: Service
metadata:
  name: qdrant
spec:
  selector:
    app: qdrant
  ports:
    - name: http
      port: 6333
      targetPort: 6333
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: qdrant
spec:
  serviceName: qdrant
  replicas: 1
  selector:
    matchLabels:
      app: qdrant
  template:
    metadata:
      labels:
        app: qdrant
    spec:
      containers:
        - name: qdrant
          image: qdrant/qdrant:latest
          ports:
            - containerPort: 6333
          volumeMounts:
            - name: qdrant-data
              mountPath: /qdrant/storage
  volumeClaimTemplates:
    - metadata:
        name: qdrant-data
      spec:
        accessModes: ["ReadWriteOnce"]
        storageClassName: "ssd-storage"
        resources:
          requests:
            storage: 100Gi
Não copie o nome ssd-storage nem o tamanho de armazenamento sem conferir o provisionador. Em produção, prefira instalar e validar o chart oficial, fixar uma versão de imagem aprovada e testar a recuperação do PVC; um StatefulSet, sozinho, não cria uma estratégia de backup nem comprova que os dados podem ser restaurados.
Limite a concorrência do processamento, tanto no número de Jobs ativos quanto na capacidade de cada worker. Uma fila com consumidores controlados protege os nós quando vários PDFs grandes chegam juntos; limites de CPU e memória reduzem o risco de um parser pressionar a API. Observe também o serviço de embeddings: chamadas remotas podem saturar limites do provedor, enquanto embeddings locais competem por CPU ou GPU.
Faça cada etapa idempotente. Um identificador estável para documento, versão e fragmento permite que uma retentativa repita upsert sem criar pontos duplicados; registre o estado da execução e valide a escrita antes de marcar a versão como publicada. A política de retentativa deve separar falha temporária, como indisponibilidade do Qdrant, de erro permanente, como PDF inválido, e precisa evitar loops que mantenham Jobs falhos consumindo recursos.
Construir o endpoint de perguntas com busca vetorial
Recuperar contexto com filtros
O endpoint recebe a pergunta por uma API FastAPI exposta via Ingress Nginx ou Istio, valida tamanho e identidade, gera o embedding da consulta e busca os pontos no Qdrant. A consulta precisa usar exatamente o mesmo modelo de embedding empregado na ingestão; vetores produzidos por modelos distintos não devem ser tratados como se ocupassem o mesmo espaço de busca. Registre a versão do modelo junto à coleção para evitar misturar vetores incompatíveis.
O filtro por tenant_id deve ser aplicado na consulta ao Qdrant, não apenas depois de recuperar resultados. Isso reduz o risco de uma resposta incorporar trechos de outro locatário e evita carregar resultados que a aplicação vai descartar. Ainda assim, o filtro não substitui autenticação: derive o tenant da identidade validada no servidor, nunca de um campo arbitrário enviado pelo cliente.
O trecho a seguir mostra a forma geral do fluxo com o cliente Python. A chamada ao serviço de embeddings e a interface do gateway de LLM são abstraídas; ajuste os nomes dos campos e métodos à versão do SDK instalada e teste a filtragem com dados de mais de um tenant.
from fastapi import FastAPI, HTTPException
from qdrant_client import QdrantClient, models

app = FastAPI()
qdrant = QdrantClient(url="http://qdrant:6333")

@app.post("/ask")
async def ask(payload: dict):
    question = payload.get("question", "").strip()
    tenant_id = payload.get("tenant_id")

    if not question or not tenant_id:
        raise HTTPException(status_code=400, detail="Dados inválidos")

    query_vector = await embeddings.encode(question)
    result = qdrant.search(
        collection_name="manuals",
        query_vector=query_vector,
        query_filter=models.Filter(
            must=[
                models.FieldCondition(
                    key="tenant_id",
                    match=models.MatchValue(value=tenant_id)
                )
            ]
        ),
        limit=5
    )

    context = "nn".join(
        f"[{hit.payload['document_id']} p.{hit.payload['page']}] "
        f"{hit.payload['text']}"
        for hit in result
    )

    prompt = (
        "Responda usando apenas o contexto abaixo. "
        "Se faltar informação, diga que não sabe. "
        "Inclua as fontes disponíveis.nn"
        f"CONTEXTO:n{context}nnPERGUNTA:n{question}"
    )
    answer = await llm.generate(prompt)
    return {"answer": answer}
Gerar respostas limitadas às fontes
Busca vetorial densa funciona bem para semelhança semântica, mas pode deixar passar identificadores exatos, códigos de produto ou termos raros. Busca híbrida combina vetores densos e esparsos; BM42 ou BM25 são alternativas para a parte lexical. O modo de combinação e a API exata dependem da versão do Qdrant e da implementação escolhida, então valide a qualidade com perguntas reais e resultados esperados.
Filtros de metadados podem ser aplicados durante a busca, junto à travessia do grafo HNSW, em vez de recuperar resultados sem filtro e removê-los depois. Isso importa em coleções com vários tenants ou documentos com permissões distintas. Verifique o comportamento e a configuração do índice no ambiente utilizado, especialmente antes de ampliar a coleção ou mudar a distribuição dos payloads.
O prompt precisa limitar o modelo ao material recuperado, mas instruções sozinhas não são uma barreira de segurança. Delimite o contexto, não trate texto de documentos como instruções do sistema e instrua o modelo a dizer quando não há evidência suficiente. Para reduzir respostas sem proveniência, vincule cada trecho a document_id e page e exija que a resposta apresente referências verificáveis.
Considere também o tamanho do contexto como um limite de produto e de custo. Se a API enviar muitos chunks, o LLM recebe texto redundante, a latência aumenta e a resposta pode ignorar justamente a passagem relevante. Defina limite de resultados, política para truncamento e comportamento quando a busca não retorna conteúdo adequado; não transforme uma coleção vazia em convite para o modelo improvisar.
Quando a resposta for transmitida por Server-Sent Events, o cliente recebe partes à medida que o gateway produz a saída. Isso melhora a percepção de espera em respostas longas, mas não elimina latência de embedding, Qdrant ou inferência, nem dispensa timeouts e cancelamento de requisições. Se o usuário fechar a conexão, interrompa o trabalho downstream quando possível para não pagar por geração que ninguém consome.
Operação, segurança e próximos passos para produção
Verificar capacidade e comportamento sob falha
Uma consulta atravessa várias dependências. Instrumente spans ou métricas separados para Ingress, API, geração de embedding, busca no Qdrant e chamada ao LLM, de modo que um aumento de latência possa ser localizado. Acompanhe erros por etapa, CPU e memória dos Pods, pressão de armazenamento e filas de ingestão; sem essa separação, um timeout genérico não mostra se o gargalo está no parser, no índice ou no provedor de inferência.
Checklist antes de expor o serviço
Não presuma que o HPA por CPU resolve toda a escala. Réplicas da API podem ajudar quando há concorrência de requisições, mas workers precisam de controle de fila e concorrência; o Qdrant depende de memória, disco e padrão de busca; o serviço de embeddings ou LLM pode ter limites de capacidade próprios. Use métricas que representem a fila e a latência, e teste como cada componente reage quando outro fica lento.
Proteja a entrada e as dependências. Valide a identidade no servidor, derive o tenant de credenciais confiáveis e imponha RBAC para restringir quem pode ler Secrets ou alterar Deployments. Use limites de rede para reduzir conexões desnecessárias entre namespaces e revise que conteúdo de PDF será enviado a provedores externos de LLM, considerando requisitos internos de privacidade e retenção.
Antes de liberar tráfego público, percorra o checklist com documentos de teste e um ambiente semelhante ao de produção:
- Confirme que os vetores permanecem disponíveis após substituir um Pod e que o procedimento de recuperação do armazenamento foi ensaiado.
- Execute a ingestão do mesmo PDF novamente e verifique que não surgem pontos duplicados nem versões parcialmente publicadas.
- Teste filtros de tenant com identidades distintas e confirme que nenhuma consulta retorna conteúdo de outro locatário.
- Defina limites de resultados e contexto, além do comportamento esperado quando não há trechos relevantes.
- Revise consumo de memória, armazenamento e chamadas de embedding e LLM com uma carga representativa.
- Simule falhas de Qdrant, Object Storage e gateway de LLM; verifique timeout, retentativa e mensagem apresentada ao usuário.
Comece com um conjunto pequeno de PDFs que contenha texto corrido e tabelas, e registre uma pergunta cuja resposta esteja em uma página conhecida. Substitua um Pod do Qdrant, repita a consulta e confirme persistência, filtros e citação da fonte; depois rode a ingestão novamente e meça recursos antes de aumentar a carga ou expor o endpoint.

Sou um profissional na área de Tecnologia da informação, especializado em monitoramento de ambientes, Sysadmin e na cultura DevOps. Possuo certificações de Segurança, AWS e Zabbix.