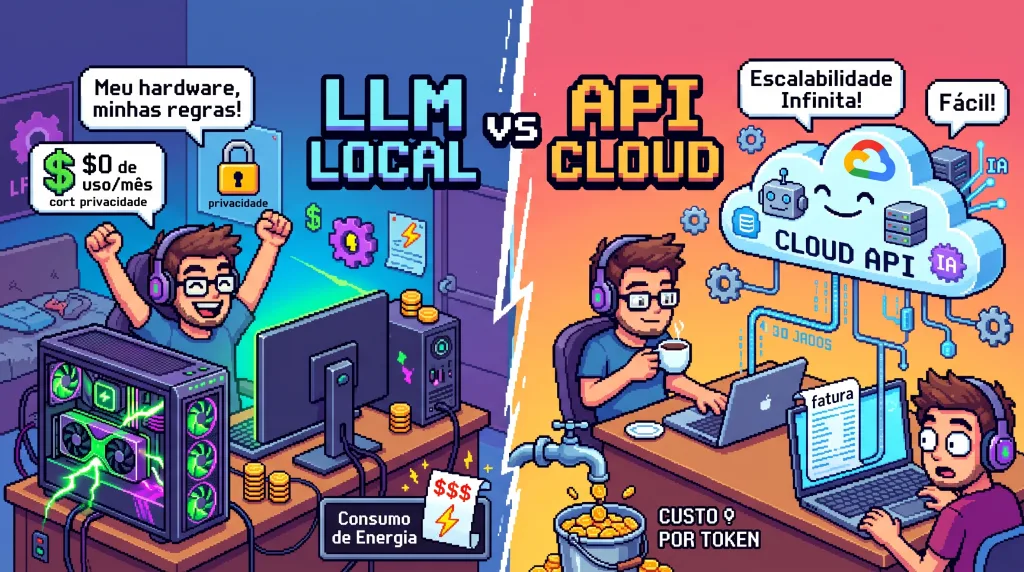
LLM pode ser executado em uma GPU própria ou acessado por uma API cloud, e a escolha costuma começar por uma pergunta simples: pagar conforme o uso ou assumir um custo fixo de infraestrutura? A resposta depende do consumo, mas também de quem opera o ambiente, quais dados podem sair da empresa e quais modelos atendem à aplicação.
Uma comparação baseada apenas na conta de computação deixa de fora a capacidade ociosa, o trabalho de manutenção e o acesso a modelos proprietários. O caminho mais adequado muda conforme a demanda: uma API pode servir bem a um protótipo e uma GPU dedicada pode fazer mais sentido quando a carga permanece alta e previsível. Não há um ponto de equilíbrio universal; há uma decisão que precisa refletir o uso real.
O que está sendo comparado: LLM local e API cloud
Como funciona a cobrança por uso
Uma API de LLM oferece acesso remoto a um modelo. A aplicação envia uma solicitação para um endereço de serviço, geralmente autenticada por uma chave, e recebe uma resposta. O custo varia conforme o consumo definido pelo fornecedor, em vez de exigir a contratação de uma GPU exclusiva para a aplicação.
Esse modelo reduz o trabalho inicial de infraestrutura. Imagine uma equipe que quer classificar mensagens recebidas por um formulário interno: ela pode integrar uma API, observar como o recurso se comporta e ajustar a aplicação sem instalar drivers ou preparar uma máquina para inferência. A cobrança acompanha o uso contratado, então uma semana tranquila tende a gerar menos consumo do que uma semana de pico.
O que significa operar uma GPU dedicada
Na alternativa dedicada, a equipe reserva uma GPU alugada em um provedor ou instala o equipamento na própria infraestrutura. O custo é fixo durante o período contratado, ainda que a capacidade fique sem uso por parte do dia. Para executar inferência, também é necessário preparar o ambiente e escolher um modelo compatível, em geral entre os modelos de pesos abertos disponíveis.
Contratar uma máquina com GPU não significa que o modelo passou a rodar localmente no computador de cada pessoa. A inferência pode acontecer em um servidor de datacenter, desde que a equipe controle esse ambiente ou tenha responsabilidade sobre sua configuração. Essa distinção importa: o local físico do equipamento, o controle operacional e o caminho dos dados são aspectos relacionados, mas não idênticos.
Na prática, a decisão compara mais do que duas formas de pagar. Uma API transfere parte da operação para o fornecedor e facilita começar; uma GPU dedicada coloca configuração, disponibilidade e manutenção nas mãos da equipe. Considere, por exemplo, quem será responsável por atualizar o ambiente de inferência quando uma dependência deixar de funcionar após uma mudança na imagem do servidor.
LLM local vs API cloud: como comparar os custos
Custo variável, custo fixo e capacidade ociosa
O custo da API cresce com o uso faturado pelo fornecedor. Esse formato tende a ser atraente quando o tráfego é baixo, irregular ou ainda está sendo medido, porque a equipe não precisa pagar por uma capacidade dedicada que permanece parada. Também permite experimentar uma funcionalidade sem comprometer a operação com um servidor reservado.
A GPU dedicada muda a conta. O valor contratado permanece mesmo quando chegam poucas solicitações, e uma máquina dimensionada para os picos pode passar longos períodos com capacidade disponível. Quando a carga é alta e constante, aproveitar essa capacidade pode tornar a alternativa mais econômica do que pagar individualmente por um volume elevado de chamadas.
O cálculo precisa incluir o trabalho necessário para manter a inferência funcionando. Drivers, CUDA, rede e segurança exigem configuração e acompanhamento; o tempo de engenharia gasto nisso também tem custo, embora não apareça como uma linha na fatura da GPU. Se a equipe depende de poucas pessoas para operar o serviço, a cobertura de incidentes e as mudanças de configuração também entram na avaliação.
O mercado de GPUs e memória RAM acrescenta outra variável. Quando esses recursos estão caros ou têm oferta limitada, a capacidade dedicada pode ficar menos atraente ou ser mais difícil de obter nas condições desejadas. Não dá para transformar essa pressão em uma economia garantida da API: os preços e as condições precisam ser verificados diretamente com os fornecedores na hora da decisão.
O ponto de virada depende do padrão de uso
O ponto de virada não é um número fixo de chamadas válido para toda aplicação. Uma carga breve concentrada em determinados horários se comporta de maneira diferente de um fluxo contínuo, mesmo que o total de solicitações de um período pareça parecido. O formato das entradas, o tamanho das respostas e o modelo escolhido também afetam o consumo observado na API.
Para comparar, registre o tráfego real por intervalo e relacione-o à conta da API. Em paralelo, estime o custo de uma configuração dedicada que consiga atender aos mesmos períodos de uso, incluindo ociosidade e operação. Uma equipe pode começar com um protótipo e coletar dados antes de cotar uma GPU; isso evita que uma previsão otimista seja tratada como demanda comprovada.
A comparação melhora quando separa carga média de pico. Se o sistema recebe muitas solicitações durante uma janela curta e quase nenhuma depois, uma máquina dimensionada para o pico pode ficar subutilizada. Já uma aplicação que processa tarefas continuamente pode aproveitar melhor a capacidade contratada, desde que o modelo e o servidor sustentem o volume necessário.
Use dados próprios e cotações atuais, sem escolher uma alternativa por uma estimativa genérica publicada em outro momento. A conta final deve refletir o padrão de uso, o modelo que entrega a qualidade necessária e o esforço de manter a operação. Minha preferência, quando a equipe já sabe trabalhar com APIs de mercado, é começar por elas: em muitos casos, o custo é mais acessível, mas a medição da aplicação deve confirmar essa impressão.
Vantagens e desvantagens de cada alternativa
API cloud: rapidez e acesso a modelos proprietários
A integração com uma API costuma ser direta: a aplicação envia uma chamada para uma URL usando uma chave de acesso. Esse caminho permite testar um recurso sem preparar uma pilha de inferência, o que ajuda equipes que ainda não sabem se a funcionalidade será usada com frequência. Quando o volume cresce, a fatura também precisa ser acompanhada.
Outro atrativo é o acesso a modelos proprietários avançados oferecidos por fornecedores. Uma equipe pode avaliar essas opções sem assumir a instalação e a atualização do modelo no próprio ambiente. A contrapartida é depender de um serviço externo, das condições comerciais do fornecedor e da disponibilidade do modelo escolhido.
Essa dependência merece atenção operacional. Se a aplicação precisa de uma resposta para concluir uma tarefa, uma falha na comunicação com a API pode afetar o fluxo inteiro. A equipe deve prever tratamento de erros, limites de tempo e uma experiência adequada quando o serviço não responde, em vez de assumir que a chamada sempre será concluída.
GPU dedicada: controle e custo previsível
Com uma GPU dedicada, o valor mensal tende a ser mais previsível do que uma cobrança variável por consumo. A equipe também escolhe como configurar o serviço de inferência e pode manter os dados dentro da infraestrutura sob seu controle. Isso favorece cenários em que o tráfego é alto e constante, mas não elimina a necessidade de acompanhar desempenho e capacidade.
O controle vem acompanhado de trabalho. Instalar drivers, configurar CUDA, cuidar da rede e revisar a segurança fazem parte da operação, e uma GPU parada continua gerando custo. Se ninguém puder monitorar o serviço ou responder a falhas, a máquina contratada não garante, sozinha, uma inferência disponível para a aplicação.
A opção dedicada também restringe a seleção aos modelos que a equipe consegue executar a partir de pesos abertos, conforme a alternativa descrita neste comparativo. Isso pode atender ao caso de uso, mas não equivale a ter acesso a todos os modelos proprietários. Antes de decidir, teste se o modelo escolhido entrega respostas adequadas para tarefas concretas, como extrair campos de uma nota fiscal de exemplo ou responder a uma consulta interna.
Privacidade e controle operacional precisam ser avaliados separadamente. Manter a inferência na própria infraestrutura reduz o envio dos dados a terceiros, mas não transforma automaticamente o ambiente em seguro. Credenciais expostas, regras de rede permissivas ou atualizações adiadas continuam criando riscos que pertencem à equipe responsável.
Privacidade, segurança e controle dos dados
O fluxo de dados em uma API
Ao usar uma API, a solicitação deixa o ambiente da aplicação e chega aos servidores do fornecedor. Isso pode incluir o texto enviado pelo usuário e informações de contexto adicionadas pelo sistema. Antes de integrar um fluxo com dados internos, verifique as políticas da organização e as condições do serviço contratado.
A avaliação precisa partir do conteúdo que será transmitido. Uma aplicação que envia apenas perguntas genéricas tem um perfil diferente de outra que encaminha documentos internos ou dados identificáveis. Defina quais campos são necessários para responder e evite enviar contexto que o modelo não precisa processar.
O que muda quando a inferência fica na infraestrutura própria
Se o modelo roda em uma infraestrutura controlada pela organização, os dados podem permanecer nesse ambiente durante a inferência. Isso reduz a exposição a terceiros, mas a equipe passa a cuidar diretamente do acesso ao servidor, da rede, das chaves e das atualizações. O desenho local precisa de controles concretos; a localização do equipamento, por si só, não os substitui.
Considere uma aplicação interna hospedada no mesmo ambiente do servidor de inferência. A equipe pode limitar quais serviços conseguem acessá-lo, proteger as credenciais e registrar as chamadas necessárias para investigar falhas. Esses controles devem acompanhar a implantação, e não ser deixados para uma revisão posterior à entrada em produção.
O diagrama mostra o fluxo simplificado, não uma garantia de segurança para qualquer arquitetura. Uma API pode ter controles contratuais e técnicos que precisam ser examinados, enquanto um servidor próprio pode estar exposto se a rede e os acessos forem mal configurados. Compare os requisitos de privacidade com as condições reais de cada opção antes de enviar dados de produção.
Como decidir: cenários de uso e critérios de escolha
Quando começar por uma API
Comece por uma API quando a demanda ainda é desconhecida, o volume é baixo ou os picos aparecem sem regularidade. A integração simples ajuda a validar se o recurso resolve o problema antes de assumir a operação de um servidor. Em um protótipo de atendimento interno, por exemplo, a equipe pode medir quantas solicitações chegam e quais respostas precisam de revisão humana.
Essa primeira etapa também ajuda a comparar modelos proprietários com alternativas que poderiam ser executadas em infraestrutura dedicada. Registre qualidade das respostas, latência percebida e consumo faturado, sem tratar uma demonstração pequena como retrato da produção. Se as chamadas aumentarem, os dados permitem refazer a conta com um padrão de uso mais confiável.
Quando avaliar uma GPU dedicada
Uma GPU merece avaliação quando há alto volume constante, a capacidade tende a ficar ocupada e a equipe precisa manter maior controle sobre o caminho dos dados. O modelo disponível também precisa atender ao caso de uso. Antes de reservar recursos, teste a inferência com entradas reais ou representativas e observe se a experiência atende à aplicação.
A operação exige alguém responsável por configuração, monitoramento e segurança. Verifique se a equipe consegue cuidar de drivers, CUDA e rede, além de responder quando o processo de inferência falhar. Se não houver essa capacidade, o custo fixo da GPU pode vir acompanhado de uma carga operacional que a estimativa financeira inicial não considerou.
Como testar uma arquitetura híbrida
Uma arquitetura híbrida pode combinar API e inferência dedicada, mas não deve ser presumida mais barata ou simples. Um serviço pode direcionar solicitações diferentes para alternativas distintas, desde que existam regras claras sobre dados, disponibilidade e tratamento de falhas. Por exemplo, consultas sem informação sensível poderiam seguir um caminho, enquanto uma tarefa que exige dados internos permaneceria em infraestrutura controlada.
Para avaliar esse desenho, meça cada caminho separadamente. Compare o custo variável das chamadas, a ocupação da GPU, a latência observada e a quantidade de trabalho operacional necessária. Também teste o que acontece quando o modelo dedicado não responde: uma tentativa automática de usar a API pode enviar dados a terceiros e contrariar uma regra de privacidade.
Em qualquer opção, o desempenho depende da combinação entre modelo, hardware e padrão de solicitações. Se a equipe estiver analisando uma configuração com vLLM ou escalabilidade automática, consulte os materiais internos pertinentes sobre inferência e autoscaling antes de definir a capacidade. O teste deve reproduzir picos plausíveis e acompanhar a fila de solicitações, não apenas confirmar que uma chamada isolada retorna uma resposta.
Próximos passos: checklist para uma decisão defensável
Dados que a equipe deve levantar
Antes de pedir cotações, descreva a carga que a aplicação realmente produz. Registre quando as solicitações chegam, como a demanda varia e qual é o consumo observado na API, se ela já estiver em uso. Separe o volume habitual dos períodos de pico para não dimensionar uma GPU com base apenas na média nem pagar por um pico hipotético permanente.
Em seguida, documente os requisitos da aplicação e da operação. Uma planilha simples ajuda a comparar as opções sem esconder custos importantes:
- Volume, horários de maior uso e variação da demanda.
- Modelos necessários e qualidade observada nas tarefas reais.
- Requisitos de privacidade e regras internas para envio de dados.
- Custos de computação, capacidade ociosa e trabalho de operação.
- Condições atuais de preço, disponibilidade e serviço oferecidas por cada fornecedor.
Solicite valores e condições atuais diretamente aos fornecedores. Uma cotação antiga pode não refletir a disponibilidade de GPUs ou memória RAM, e uma estimativa genérica não incorpora o padrão particular da sua aplicação. Registre também quem responde por segurança, atualizações e incidentes caso a equipe opte por operar a GPU.
Erros comuns na estimativa
Um erro frequente é comparar somente a cobrança da API com o aluguel mensal da GPU. A primeira pode variar com o consumo; a segunda continua quando há capacidade ociosa, e ambas dependem do modelo e do padrão de uso. Outro erro é ignorar o tempo necessário para configurar e manter o serviço dedicado, como se essa operação não ocupasse pessoas.
Também evite escolher apenas pelo controle dos dados ou pela possibilidade de acessar um modelo avançado. Verifique se a alternativa atende aos requisitos completos da aplicação, incluindo privacidade, qualidade de resposta e disponibilidade operacional. Quando a carga mudar, repita a comparação: uma decisão adequada para um protótipo pode não servir a um serviço de uso contínuo.
Uma sequência prática é prototipar com a opção mais simples de testar, medir o comportamento real e calcular o custo total com cotações atuais. Depois, compare API, GPU dedicada e, se houver motivo, uma arquitetura híbrida, incluindo as responsabilidades de segurança e operação. Reavalie quando o volume, a regularidade da demanda ou as regras sobre dados mudarem.
Perguntas frequentes
Uma API de LLM sempre cobra apenas pelos tokens enviados?
O modelo de cobrança depende do fornecedor e do serviço contratado. Confira a página oficial de preços e as condições aplicáveis à sua conta antes de estimar o gasto.
Ter uma GPU dedicada significa que qualquer LLM pode ser executado nela?
Não. A compatibilidade depende do modelo, dos recursos de hardware disponíveis e da configuração do software. Verifique os requisitos do modelo escolhido antes de contratar ou instalar a GPU.
É possível manter dados sensíveis e ainda usar uma API cloud?
Isso depende dos requisitos da organização e das condições oferecidas pelo provedor. A equipe deve revisar políticas de dados, controles disponíveis e obrigações aplicáveis antes de enviar informações sensíveis.
Como evitar pagar por uma GPU que fica ociosa?
Compare a capacidade contratada com a demanda real ao longo do tempo, incluindo períodos de baixa utilização. Se a carga for irregular, avalie se uma alternativa cobrada por consumo atende melhor ao padrão observado.
Uma solução híbrida exige duplicar a operação?
Ela pode aumentar a complexidade, pois envolve integrar e monitorar mais de um caminho de inferência. Só vale adotá-la depois de definir critérios claros para encaminhar solicitações e medir o custo operacional adicional.

Sou um profissional na área de Tecnologia da informação, especializado em monitoramento de ambientes, Sysadmin e na cultura DevOps. Possuo certificações de Segurança, AWS e Zabbix.