DevOps e Automação
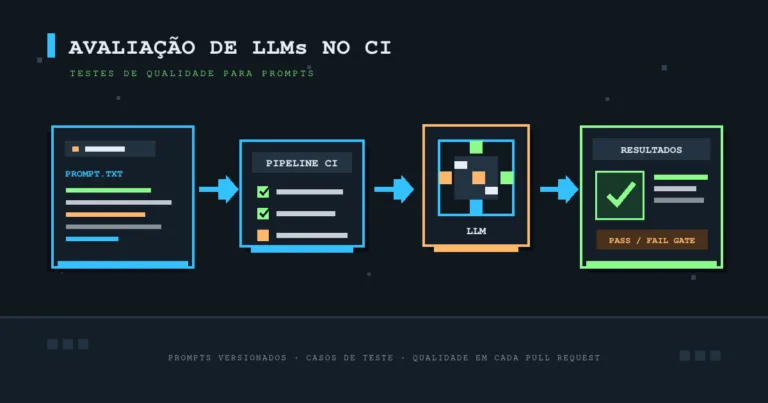
Avaliação de LLMs no CI: como criar testes de qualidade para prompts e respostas
Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.

Engenharia de infraestrutura para Inteligência Artificial, LLMs e MLOps em produção. Explore arquiteturas para servir modelos locais com vLLM e GPUs no Kubernetes, autoscaling de inferência com KEDA, pipelines RAG com bancos vetoriais (Qdrant), AIOps, automação de agentes e guardrails de segurança em servidores.
Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.
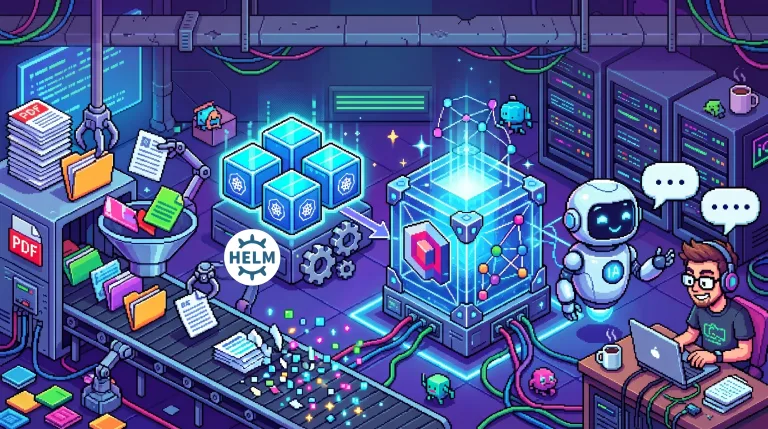
Um roteiro técnico para estruturar RAG no Kubernetes com Qdrant, separando ingestão assíncrona e consulta síncrona. O plano inclui decisões de armazenamento, chunking, filtros, exemplos de configuração e cuidados operacionais.
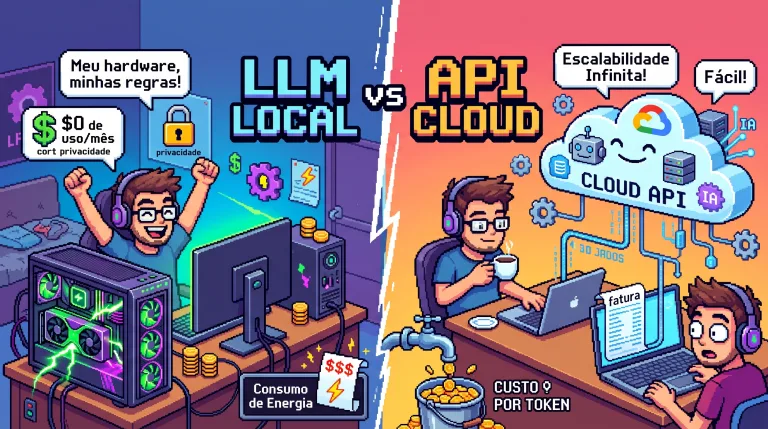
GPU própria e API cloud atendem a necessidades diferentes. Veja como comparar o custo total, a privacidade e o trabalho operacional antes de escolher onde executar um LLM.
Em workloads de inferência, CPU e memória nem sempre mostram quando a capacidade está saturada. Veja como combinar métricas do vLLM e KEDA para escalar pods com base em fila e latência, considerando também o tempo de carregamento do modelo.
Servir LLMs no Kubernetes com vLLM parece simples até o primeiro pico de tráfego. O que separa uma prova de conceito de um serviço confiável é medir TTFT, controlar GPU e aceitar as limitações reais da fila.
Construir um agente DevOps com LangChain deixou de ser experimento de laboratório e já é uma forma real de reduzir tarefas repetitivas de administração de.
Construir uma infraestrutura self-healing deixou de ser luxo reservado a big techs e passou a ser requisito básico para qualquer time que opera clusters.
A infraestrutura moderna está passando por uma transformação silenciosa mas profunda. Enquanto tradicionalmente logs, métricas e dados operacionais foram.
A implementação eficaz de soluções de Machine Learning em produção demanda mais do que algoritmos robustos; requer uma infraestrutura MLOps coesa.