DevOps e Automação
Avaliação de LLMs no CI: como criar testes de qualidade para prompts e respostas
Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.

Avaliação de LLMs no CI: aprenda a medir qualidade de respostas, detectar regressões e bloquear mudanças ruins antes do deploy.
Um roteiro técnico para estruturar RAG no Kubernetes com Qdrant, separando ingestão assíncrona e consulta síncrona. O plano inclui decisões de armazenamento, chunking, filtros, exemplos de configuração e cuidados operacionais.
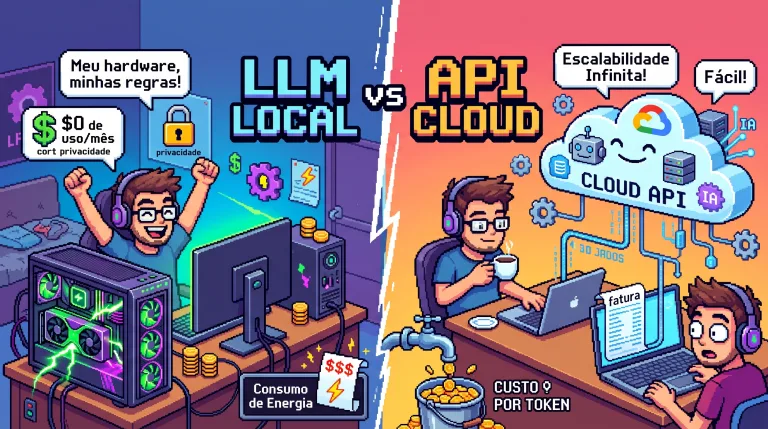
GPU própria e API cloud atendem a necessidades diferentes. Veja como comparar o custo total, a privacidade e o trabalho operacional antes de escolher onde executar um LLM.
Em workloads de inferência, CPU e memória nem sempre mostram quando a capacidade está saturada. Veja como combinar métricas do vLLM e KEDA para escalar pods com base em fila e latência, considerando também o tempo de carregamento do modelo.
Servir LLMs no Kubernetes com vLLM parece simples até o primeiro pico de tráfego. O que separa uma prova de conceito de um serviço confiável é medir TTFT, controlar GPU e aceitar as limitações reais da fila.
segurança de gpu: Edera aplica isolamento por hipervisor para proteger workloads GPU e reduzir riscos em ambientes multi-inquilino com IA autônoma.
Pesquisa mostra que modelos de linguagem podem reidentificar usuários pseudônimos em redes sociais com alta precisão, expondo riscos à privacidade e sugerindo
A inteligência artificial transformou radicalmente a forma como desenvolvemos software nos últimos anos. O GitHub Copilot popularizou o conceito de.