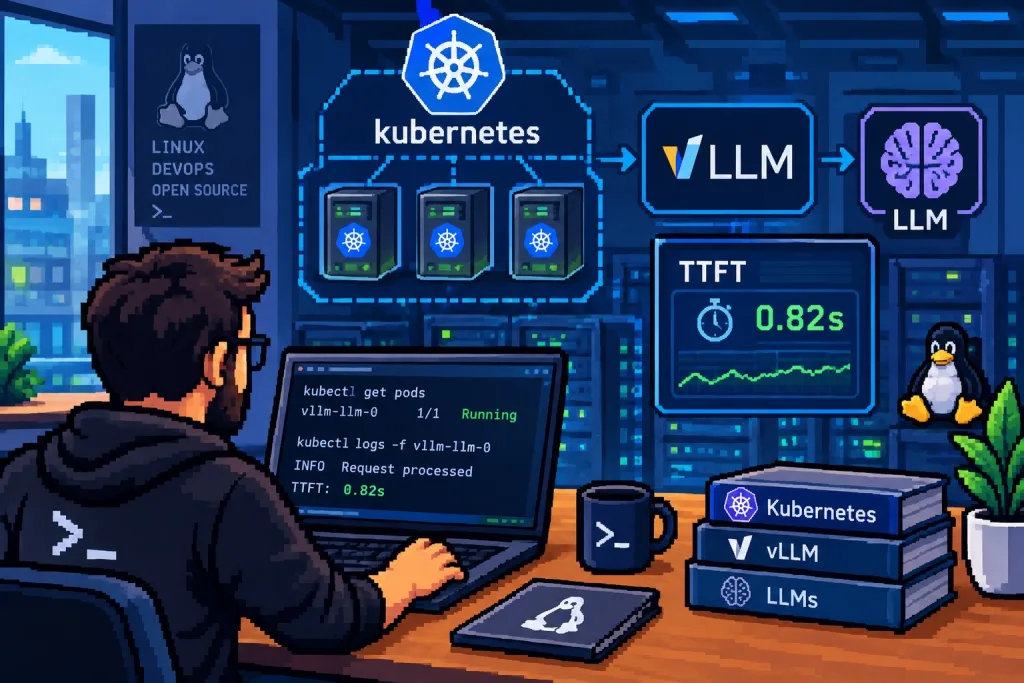
Servir LLMs no Kubernetes com vLLM parece elegante no slide. Na prática, a conta chega rápido: GPU cara, fila mal comportada, cold start irritante e um TTFT que desmonta qualquer promessa bonita se você não medir direito.
O ponto aqui não é “colocar IA em produção” como se isso fosse um selo mágico. O foco é operar um serviço de inferência com previsibilidade, usando Kubernetes para agendamento, isolamento e autoscaling onde ele realmente ajuda — e usando vLLM porque ele entrega throughput decente sem exigir uma ginástica absurda de código.
Comece pelo que realmente importa
Antes do YAML, defina a carga. Qual modelo vai rodar? Quantos tokens por requisição? Qual latência aceitável para o primeiro token? Sem isso, você só está montando um cluster caro para descobrir depois que o gargalo era o tamanho do contexto ou a fila interna do servidor.
TTFT — time to first token — é a métrica que costuma expor a verdade cedo. Ela mostra quanto tempo o usuário espera até ver algo útil na tela, e em chatbots isso pesa mais do que o tempo total da resposta em vários casos. Se o TTFT passa de alguns segundos sem explicação clara, a experiência degrada rápido.
Não trate throughput como vitória automática. Um servidor pode processar muita coisa por minuto e ainda assim entregar uma primeira resposta lenta demais para parecer responsivo.
Arquitetura mínima para não se enganar
O desenho mais simples começa com um Deployment rodando o container do vLLM atrás de um Service interno. Em geral, você quer uma única réplica por GPU dedicada, porque compartilhar GPU entre processos concorrentes sem critério vira loteria operacional. Se houver múltiplas GPUs por nó, planeje afinidade e tolerações desde o início.
Também vale separar preocupação de inferência e preocupação de plataforma. O time de app quer endpoint estável; o time de infra precisa lidar com node pool com GPU, driver NVIDIA compatível, runtime correto e limites bem definidos. Misturar tudo no mesmo manifesto costuma virar manutenção dolorosa quando chega atualização de driver ou mudança no kernel.
- Use nodes com GPU isolada para inferência.
- Defina requests e limits coerentes com a placa disponível.
- Evite overcommit agressivo em memória compartilhada.
- Mantenha readinessProbe e livenessProbe simples.
Nessa etapa, muita gente erra tentando esconder fragilidade com HPA. Escalar pods não resolve falta de VRAM nem melhora TTFT se cada réplica já nasce saturada. O ganho real vem de ajustar batch size, contexto máximo e concorrência interna do vLLM antes de pensar em multiplicar instâncias.
Deployment do vLLM sem maquiagem
Um Deployment básico precisa declarar imagem correta, porta exposta e recursos explícitos. Se você usa Helm ou Kustomize, ótimo — mas não deixe a configuração esconder parâmetros importantes como --model, --tensor-parallel-size, --max-model-len e limites de tokens simultâneos. Esses detalhes mudam completamente o comportamento sob carga.
A imagem deve casar com CUDA, driver e versão do PyTorch usados pelo vLLM. Esse ponto falha muito em ambiente misto: funciona no notebook da equipe, quebra no cluster porque a build foi feita para outra base ou porque faltou suporte ao runtime NVIDIA Container Toolkit. Em produção isso aparece como pod preso em CrashLoopBackOff ou como inicialização lenta demais para ser útil.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-server
spec:
  replicas: 1
  selector:
    matchLabels:
      app: vllm-server
  template:
    metadata:
      labels:
        app: vllm-server
    spec:
      containers:
        - name: vllm
          image: your-registry/vllm-openai:latest
          args:
            - --model
            - meta-llama/Llama-3-8B-Instruct
            - --host
            - 0.0.0.0
            - --port
            - "8000"
          ports:
            - containerPort: 8000
          resources:
            requests:
              nvidia.com/gpu: "1"
              cpu: "4"
              memory: "16Gi"
            limits:
              nvidia.com/gpu: "1"
              cpu: "8"
              memory: "32Gi"
Esse tipo de manifesto não resolve tudo. Ele só evita autoengano básico. Depois disso vêm os detalhes chatos — afinidade por nó GPU, nodeSelector para pool dedicado, PodDisruptionBudget se houver janela sensível e política clara para rollout sem derrubar requisições em andamento.
GPU scheduling pede disciplina
Kubernetes não adivinha sua intenção quando a carga depende de hardware especializado. Se você tem nós heterogêneos, rotule os nodes certos e use tolerations para impedir que workloads comuns ocupem espaço reservado para inferência pesada. Sem isso, o cluster fica “cheio” no lugar errado justamente quando você precisa escalar.
A afinidade também ajuda bastante quando há várias GPUs por host e você quer evitar fragmentação inútil. Já vi ambiente em que metade das réplicas ficava presa porque o scheduler colocava pods em nós sem folga suficiente na memória da placa — resultado clássico de planejamento otimista demais e observabilidade fraca demais para perceber cedo.
- Reserve node pool exclusivo para GPU.
- Aplique taints nos nós críticos.
- Use affinity por zona ou tipo de placa quando houver diferença relevante.
- Mantenha monitoramento da VRAM fora do cluster também — via DCGM Exporter ou equivalente.
Se você pretende usar autoscaling, pense primeiro no Cluster Autoscaler ou Karpenter respondendo à demanda do nó certo; depois veja HPA no nível do pod. Para inferência LLM isso costuma funcionar melhor quando há fila previsível e capacidade sobrando na camada física. Sem folga real na infraestrutura, autoscaling vira apenas reação atrasada ao congestionamento.
TTFT mede percepção; throughput mede fôlego
Benchmark sério começa com duas perguntas simples: quanto tempo até o primeiro token e quantas requisições sustentadas por segundo seu serviço aguenta sem degradação brutal? O TTFT captura percepção humana; throughput mostra quanto custo por unidade você consegue absorver antes da conta ficar feia demais.
No vLLM, parâmetros como paged attention ajudam a melhorar utilização da memória e reduzir desperdício na gestão dos KV caches. Isso é ótimo — desde que você teste com prompts parecidos com os reais. Benchmark sintético demais engana fácil; uma carga curta pode esconder problema grave em prompts longos ou concorrência alta.
Teste com tráfego parecido com produção ou aceite que seus números são decorativos. Benchmark bonito em lote pequeno costuma morrer na primeira segunda-feira útil.
Métricas úteis durante o teste
- TTFT p50 e p95 para sentir responsividade real.
- Total latency por faixa de tamanho de prompt.
- Taxa de erro por timeout ou OOM na GPU.
- Saturação da VRAM durante janelas longas.a0
- Tamanho médio da fila interna do servidor.a0
No campo prático, use ferramentas como hey, wrk, Locust ou scripts próprios chamando a API compatível com OpenAI exposta pelo vLLM. Registre tudo em Prometheus se puder — inclusive métricas customizadas do servidor — porque olhar só log bruto depois é pedir retrabalho durante incidente noturno.
Observabilidade não é enfeite
Sem observabilidade decente você vai culpar a rede quando o problema for VRAM fragmentada; vai culpar o modelo quando o gargalo for CPU fazendo pré-processamento; vai culpar o Kubernetes quando era apenas falta de readiness bem definida. É assim que incidentes viram caça às bruxas técnica.
A combinação mais útil costuma ser logs estruturados, métricas expostas pelo próprio servidor e dashboards focados nas poucas variáveis que importam sob carga. Prometheus coleta latência, taxa de erro e uso da GPU; Grafana mostra tendência; OpenTelemetry ajuda se houver cadeia maior envolvendo gateway HTTP ou camada RAG antes da inferência.
- Mensure tempo até aceitar conexão HTTP.a0
- Mensure tempo até gerar primeiro token.a0
- Mensure queda brusca após aumento gradual da concorrência.a0
- Mantenha alertas separados para erro funcional e saturação física.a0
Evitando as armadilhas mais caras
A armadilha número um é achar que qualquer modelo roda igual em qualquer GPU disponível. Não roda. Modelos maiores exigem memória específica, quantização bem pensada e margem operacional para picos inesperados; senão você ganha OOM intermitente bem na hora errada. p>A segunda armadilha é ignorar custo operacional enquanto celebra economia teórica da IA localizada no cluster próprio. GPU parada custa caro; GPU subutilizada custa quase tão caro quanto uma mal dimensionada; GPU saturada derruba experiência e gera retrabalho humano imediato — triagem manual aumenta porque ninguém confia mais na resposta automatizada. ul>
Perguntas frequentes
Como escolher entre múltiplas réplicas ou uma réplica por GPU?
Para inferência LLM pesada, uma réplica por GPU costuma ser mais previsível. Múltiplas réplicas dividindo a mesma placa podem funcionar em laboratório, mas aumentam contenção na VRAM e deixam TTFT instável sob pico.
TTFT deve ser medido junto com quais outras métricas?
Junto com latência total por faixa de prompt, taxa de erro por timeout/OOM e saturação da VRAM. Só TTFT pode dar falsa sensação de saúde se as respostas completas estiverem degradadas.
vLLM substitui necessidade de observabilidade?
Não substitui nada disso. Ele melhora eficiência da inferência, mas sem Prometheus, logs estruturados e dashboards claros você continua cego quando surgir fila excessiva ou falha intermitente.
Quando não vale usar Kubernetes para servir LLMs?
Quando a operação ainda está pequena demais para justificar complexidade extra ou quando a equipe não consegue manter nós GPU corretamente configurados. Nesses casos um serviço gerenciado pode sair mais barato operacionalmente.

Sou um profissional na área de Tecnologia da informação, especializado em monitoramento de ambientes, Sysadmin e na cultura DevOps. Possuo certificações de Segurança, AWS e Zabbix.